
← मेरा काम › AI और मशीन लर्निंग
मशीन ख़राब होने से पहले पहचान: और यह भी जानना कि मॉडल कब पुराना पड़ गया
मशीन के सेंसर डेटा पर पूरा MLOps चक्र: हर खेप (बैच) की जाँच, मॉडल सिखाना और उनका हिसाब रखना, सबसे अच्छे मॉडल को और निखारना, बदलाव (ड्रिफ़्ट) पर नज़र रखना, और SHAP से हर ख़राबी की वजह समझाना।
तैयार है
PythonMLOpsXGBoostMLflowOptunaEvidentlySHAP
यह काम कृतिकेश राजपुरोहित का है। डेटा की साफ़-सफ़ाई और लिखने में एक AI सहायक (Claude) का हाथ बँटा।
Hugging Face पर लाइव डेमोHugging Face पर मॉडल कार्डGitHub पर कोडKaggle पर नोटबुकKaggle पर डेटा
ख़ुद चलाकर देखिए
कुछ शब्द पहले:
- मॉडल यानी कंप्यूटर का ऐसा प्रोग्राम जो पुराने उदाहरण देखकर अंदाज़ा लगाना सीखता है।
- MLOps (मशीन लर्निंग ऑपरेशन्स) यानी मॉडल को सिर्फ़ बनाना नहीं, बल्कि उसके पूरे जीवन की देखभाल: डेटा जाँचना, मॉडल सिखाना, हिसाब रखना, और काम पर लगने के बाद भी नज़र रखना।
- सेंसर यानी मशीन पर लगा छोटा यंत्र, जो तापमान, रफ़्तार जैसी चीज़ें लगातार नापता है।
- टॉर्क यानी घुमाने वाला ज़ोर (Nm में नापा जाता है)। rpm यानी एक मिनट में कितने चक्कर।
- टूल वियर यानी औज़ार कितने मिनट चलकर घिस चुका है।
समस्या
एक कारख़ाने में हज़ारों मशीनें चलती हैं। हर मशीन छह चीज़ें भेजती है: मशीन का प्रकार, हवा का तापमान, काम (प्रोसेस) का तापमान, घूमने की रफ़्तार, टॉर्क और टूल वियर। अगर कोई मशीन अचानक बंद हो जाए, तो पूरा काम रुक जाता है और बहुत नुक़सान होता है।
लक्ष्य: एक रीडिंग (एक बार की नाप) देखकर बताना कि मशीन ठीक है, या चार में से किसी ख़राबी की ओर जा रही है।
| कोड | ख़राबी का प्रकार | सिखाने वाली 6,993 पंक्तियों में हिस्सा |
|---|---|---|
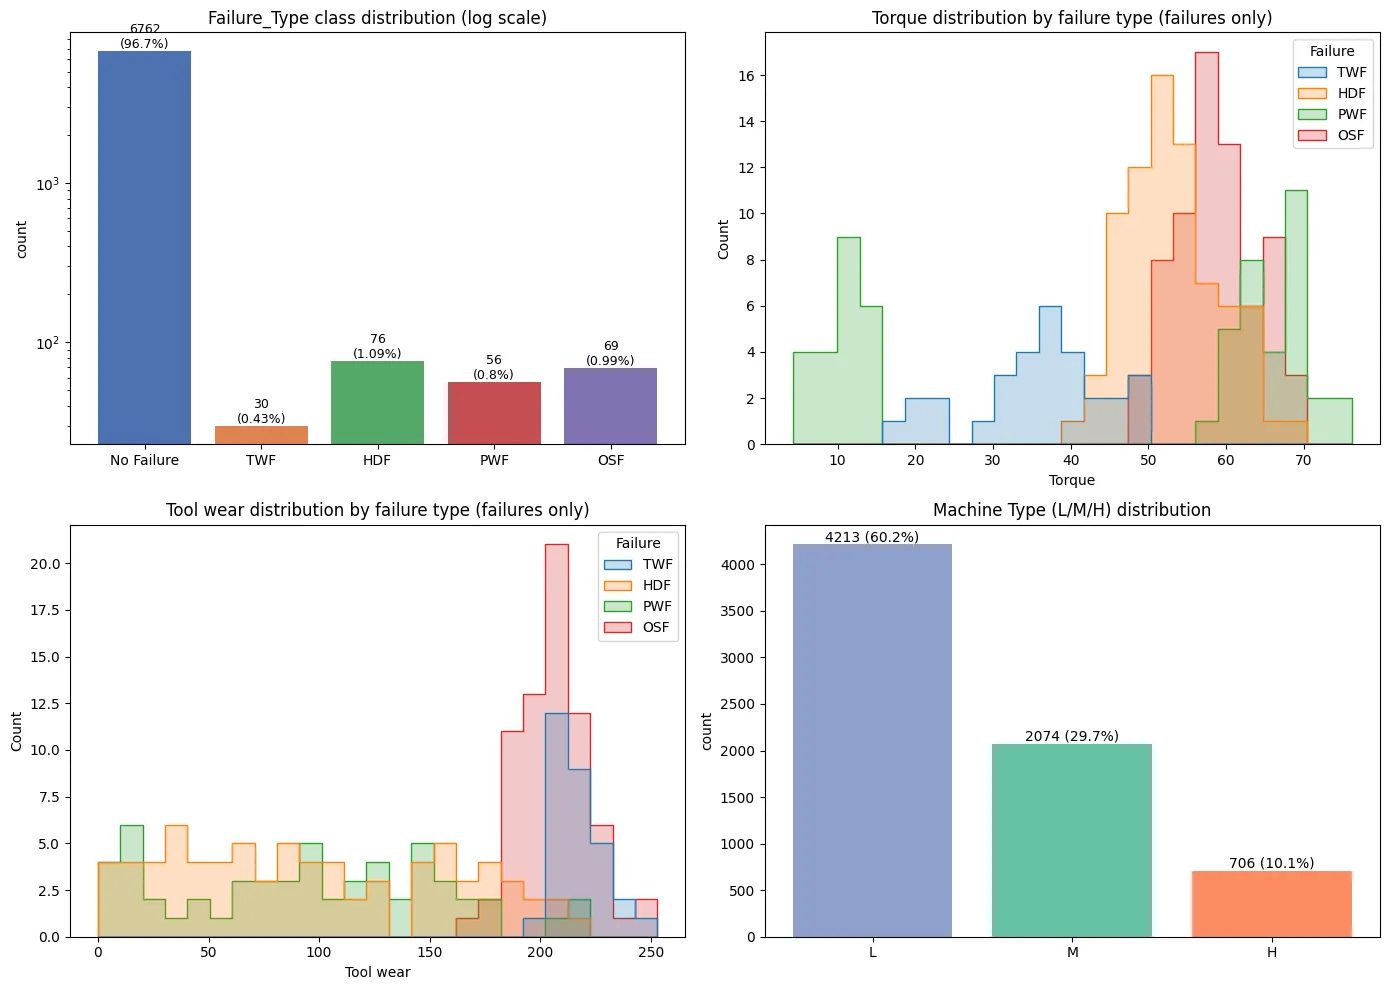
| 0 | कोई ख़राबी नहीं | 96.70% |
| 1 | TWF: औज़ार घिसने से ख़राबी | 0.43% (सिर्फ़ 30 पंक्तियाँ) |
| 2 | HDF: गर्मी बाहर न निकल पाने से ख़राबी | 1.09% |
| 3 | PWF: बिजली (पावर) की ख़राबी | 0.80% |
| 4 | OSF: ज़रूरत से ज़्यादा ज़ोर (ओवरस्ट्रेन) से ख़राबी | 0.99% |
दो बातें इसे मुश्किल बनाती हैं। पहली, ख़राबियाँ बहुत कम होती हैं: जो मॉडल हर बार “ठीक है” बोल दे, वह 96.7% सही दिखेगा, पर एक भी ख़राबी नहीं पकड़ेगा। दूसरी, मॉडल के काम पर लगने के बाद कारख़ाने के हालात बदल जाते हैं, और मॉडल चुपचाप कमज़ोर हो सकता है।
तरीक़ा
इस प्रोजेक्ट में मॉडल का पूरा जीवन देखा गया, सिर्फ़ सिखाना नहीं:
- डेटा की जाँच (Pandera). एक “डेटा अनुबंध” (नियमों की सूची) हर कॉलम को भौतिक सीमाओं से जाँचता है, जैसे टॉर्क 3 से 80 Nm के बीच, टूल वियर 0 से 253 मिनट के बीच। तीनों बैच (खेप) इस जाँच में पास हुए।
- भौतिकी से नई चीज़ें (फ़ीचर) बनाना. यांत्रिक शक्ति (मैकेनिकल पावर),
Power_W = Torque × 2π × rpm / 60, और तापमान का अंतर,Temp_diff = प्रोसेस तापमान − हवा का तापमान। - कम-ज़्यादा का संतुलन. डेटा को 80/20 में बाँटा, हर वर्ग का हिस्सा बराबर रखते हुए (स्ट्रैटिफ़ाइड)। फिर SMOTE (जो दुर्लभ ख़राबियों के नक़ली मगर मिलते-जुलते उदाहरण बनाता है) सिर्फ़ सीखने वाले हिस्से पर लगाया, ताकि जाँच वाला हिस्सा असली जैसा रहे।
- मॉडलों की तुलना और हिसाब (MLflow). चार मॉडल आज़माए: Logistic Regression, Random Forest, XGBoost और LightGBM। हर बार के नतीजे MLflow में दर्ज किए।
- निखारना और दर्ज करना (Optuna + MLflow Registry). Optuna ने 30 बार अलग-अलग सेटिंग आज़माकर XGBoost को बेहतर किया। सबसे अच्छा मॉडल
PredMaint_XGBoostनाम सेproduction(यानी “यही काम पर लगेगा”) लेबल के साथ दर्ज हुआ। - बदलाव पर नज़र (Evidently). दो नए बैच आए: एक सामान्य दिनों का, एक भारी काम (हेवी-लोड) के दिनों का। दोनों को सिखाने वाले डेटा से मिलाया।
- वजह समझाना (SHAP). SHAP बताता है कि किस नाप ने मॉडल के फ़ैसले को कितना धकेला। इसे हर ख़राबी के लिए अलग-अलग पढ़ा गया।
नतीजे
पहले दो शब्द: एक्यूरेसी यानी कुल कितने जवाब सही निकले। F1 स्कोर (0 से 1 के बीच) बताता है कि मॉडल किसी एक ख़राबी को कितनी अच्छी तरह पकड़ता है, बिना ज़्यादा झूठे अलार्म के। मैक्रो F1 यानी पाँचों वर्गों के F1 का औसत, जिसमें हर ख़राबी को बराबर महत्व मिलता है।
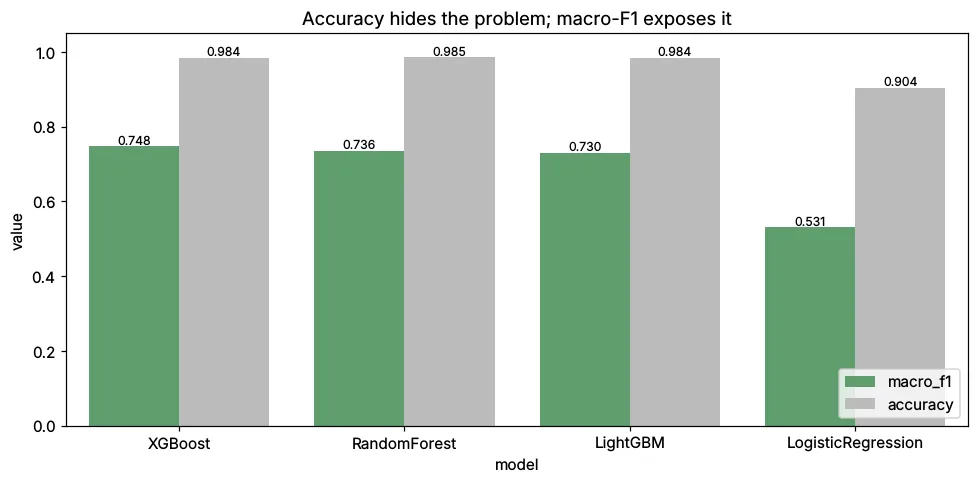
सिर्फ़ एक्यूरेसी असली कमी छिपा देती है
| मॉडल | मैक्रो F1 | एक्यूरेसी | TWF का F1 | OSF का F1 |
|---|---|---|---|---|
| XGBoost | 0.748 | 0.984 | 0.133 | 0.769 |
| Random Forest | 0.736 | 0.985 | 0.000 | 0.800 |
| LightGBM | 0.730 | 0.984 | 0.000 | 0.857 |
| Logistic Regression | 0.531 | 0.904 | 0.145 | 0.650 |
| Optuna से निखारा गया XGBoost | 0.767 | 0.977 | 0.069 | 0.897 |
Random Forest की एक्यूरेसी सबसे ज़्यादा थी, फिर भी उसने औज़ार घिसने वाली एक भी ख़राबी नहीं पकड़ी। मैक्रो F1 हर ख़राबी को बराबर गिनता है, इसलिए उसने XGBoost को चुना। निखारने के बाद मैक्रो F1 0.019 बढ़ा (+2.6%), सबसे ज़्यादा ओवरस्ट्रेन में (OSF का F1 0.77 से 0.90)।
सही डेटा का मतलब जाना-पहचाना डेटा नहीं
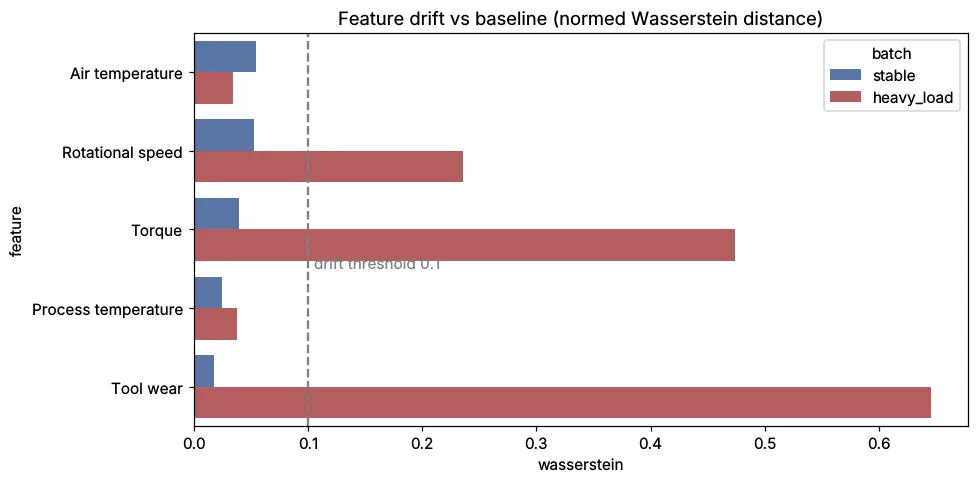
ड्रिफ़्ट यानी नए डेटा का पैटर्न पुराने (सिखाने वाले) डेटा से खिसक जाना। भारी काम वाला बैच Pandera की हर जाँच में पास हुआ, यानी हर नाप मुमकिन थी। फिर भी Evidently ने 5 में से 3 चीज़ों में ड्रिफ़्ट पकड़ा। सामान्य बैच में कोई ड्रिफ़्ट नहीं था।
| चीज़ (भारी काम वाला बैच) | ड्रिफ़्ट स्कोर (Wasserstein, यानी दो बँटवारों की दूरी) | सिखाने वाले डेटा का औसत | इस बैच का औसत | बदलाव |
|---|---|---|---|---|
| टूल वियर | 0.646 | 107.7 मिनट | 148.9 मिनट | +38.3% |
| टॉर्क | 0.474 | 40.0 Nm | 44.7 Nm | +11.8% |
| घूमने की रफ़्तार | 0.235 | 1,539 rpm | 1,497 rpm | −2.7% |
| प्रोसेस तापमान | 0.038 | 310.0 K | 310.0 K | 0.0% |
| हवा का तापमान | 0.034 | 300.0 K | 300.1 K | 0.0% |
| बैच | कितनी चीज़ें खिसकीं | मैक्रो F1 | एक्यूरेसी | OSF का F1 | OSF का हिस्सा |
|---|---|---|---|---|---|
| सामान्य | 5 में से 0 | 0.742 | 0.966 | 0.813 | 1.00% |
| भारी काम | 5 में से 3 | 0.532 | 0.883 | 0.626 | 3.87% |
हर ख़राबी की अपनी भौतिकी
| ख़राबी | सबसे बड़ी वजह (औसत SHAP) | कारख़ाने की भाषा में मतलब |
|---|---|---|
| TWF | टूल वियर (3.13) | औज़ार की उम्र पूरी हो गई। |
| HDF | तापमान का अंतर (2.70), फिर रफ़्तार (1.97) | तापमान का अंतर कम और रफ़्तार धीमी: गर्मी बाहर नहीं निकल पाती। |
| PWF | यांत्रिक शक्ति (3.24) | शक्ति सुरक्षित दायरे से बाहर: बहुत कम (मशीन अटकना) या बहुत ज़्यादा (ओवरलोड)। |
| OSF | टॉर्क (1.90), फिर टूल वियर (1.87) | घिसा हुआ औज़ार भारी ज़ोर के नीचे अपनी सीमा पार कर जाता है। |
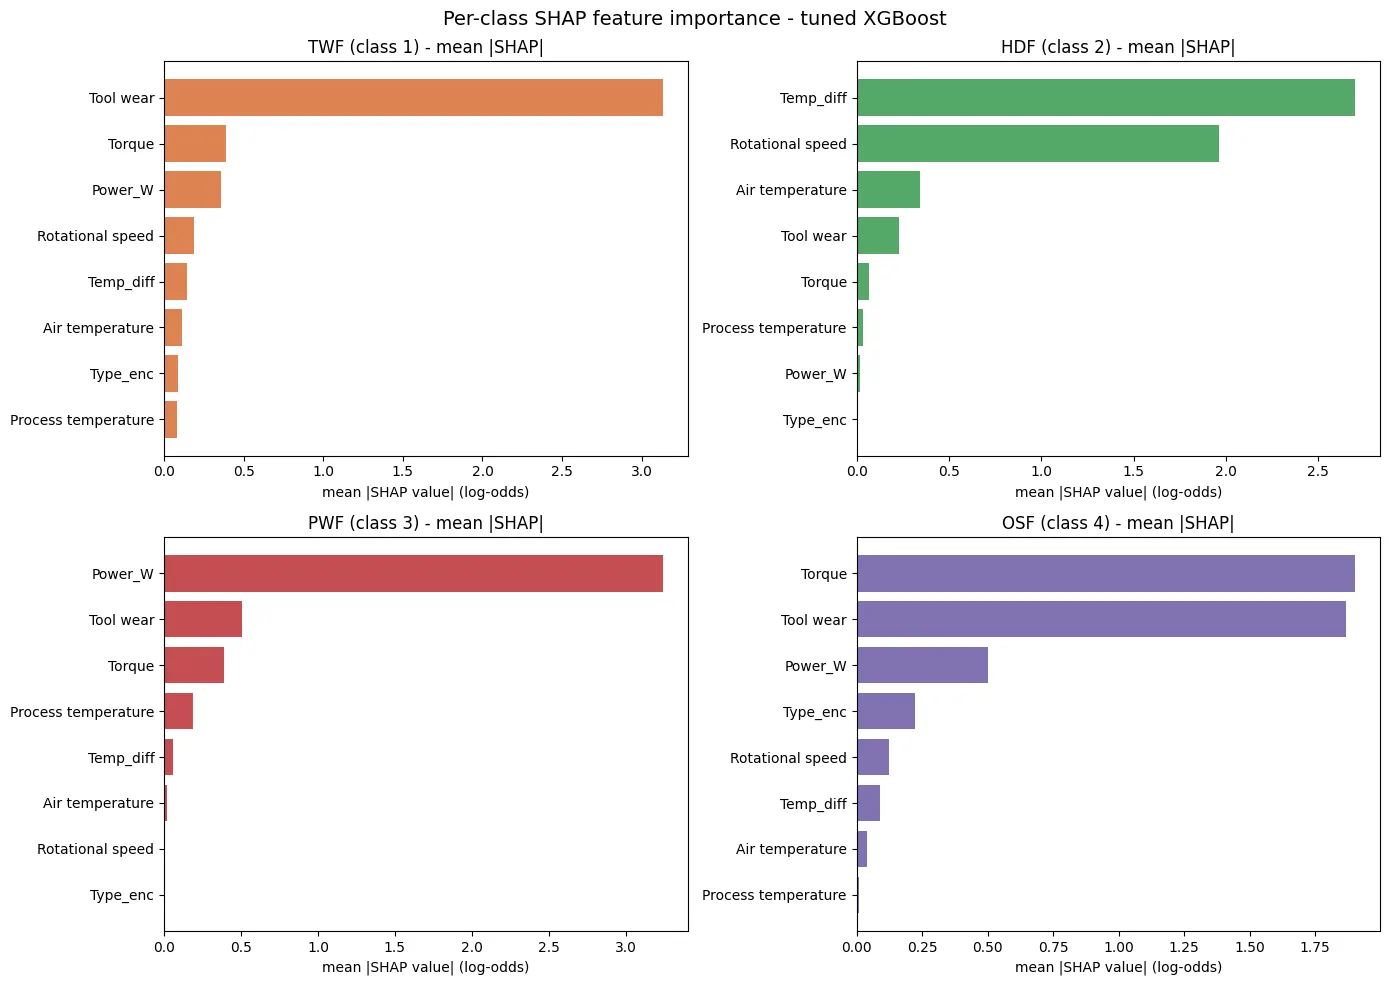
भौतिकी से बनाई गई दोनों नई चीज़ें सबसे ऊपर आईं: बिजली वाली ख़राबी में यांत्रिक शक्ति (अकेले टॉर्क से लगभग 8 गुना असरदार), और गर्मी वाली ख़राबी में तापमान का अंतर।
फ़ैसला
जो दो चीज़ें सबसे ज़्यादा खिसकीं, टॉर्क और टूल वियर, वही ओवरस्ट्रेन की दो सबसे बड़ी वजहें हैं। भारी काम के दिनों में ओवरस्ट्रेन के मामले लगभग 4 गुना हुए (0.99% से 3.87%), और मॉडल का OSF वाला F1 0.90 से गिरकर 0.63 रह गया। इसलिए मॉडल को भारी काम वाले डेटा के साथ दोबारा सिखाना (रीट्रेन) चाहिए, और नया मॉडल तभी काम पर लगे जब वह भारी काम वाले जाँच-डेटा पर पुराने से बेहतर निकले।
सबूतों से एक आसान नियम भी निकला: जब टूल वियर × टॉर्क लगभग 10,000 (मिनट·Nm) से ऊपर जाए, तो चेतावनी दो। सिखाने वाले डेटा में ओवरस्ट्रेन की हर ख़राबी 11,000 से ऊपर थी। भारी काम में 11.4% रीडिंग 11,000 पार करती हैं, जबकि सामान्य दिनों में सिर्फ़ 1.3%।
जो काम नहीं किया
औज़ार घिसने वाली ख़राबी (TWF) कमज़ोर ही रही (निखारने के बाद F1 0.07)। इसके सिर्फ़ 30 असली उदाहरण हैं, और SMOTE उन्हीं थोड़े-से उदाहरणों को मिला सकता है, असली विविधता नहीं ला सकता। सही इलाज है ज़्यादा डेटा: हर बार औज़ार बदलते समय उसकी घिसावट दर्ज करना, और कंपन (वाइब्रेशन) या आवाज़ वाले सेंसर लगाना। तब तक इस ख़राबी के लिए “इतने मिनट बाद औज़ार बदल दो” वाला तय नियम मॉडल से ज़्यादा भरोसेमंद है।
दूसरी सीमाएँ: डेटा एक सार्वजनिक, बनाया हुआ (सिंथेटिक) अभ्यास-डेटा है (AI4I 2020, UCI मशीन लर्निंग रिपॉज़िटरी), इसलिए असली मशीनों पर ये सीमाएँ फिर से जाँचनी होंगी। दुर्लभ ख़राबियों की जाँच में हर एक की सिर्फ़ 6 से 15 पंक्तियाँ थीं।
यह कैसे बना
यह IIIT बैंगलोर (upGrad के साथ) के Applied AI और Agentic AI कार्यक्रम का कैपस्टोन (आख़िरी बड़ा) प्रोजेक्ट है। Google Colab में Python और इन टूल्स से चलाया गया: scikit-learn, imbalanced-learn, XGBoost, LightGBM, MLflow, Optuna, Evidently, SHAP और Pandera। टेस्ट, CI (हर बदलाव पर अपने-आप चलने वाली जाँच) और छोटे डेमो वाला साफ़-सुथरा रिपॉज़िटरी वर्ज़न Claude की मदद से डिज़ाइन किया गया।